Volver al Laboratorio · Laboratorio / Método / Experimento 01
Versión fija, muestras conservadas, unidades claras y límites explícitos. Así construimos una referencia que podamos volver a usar dentro de la empresa y que otra persona pueda revisar.
Protocolo sp-cpu-v1. Primera comparación: 18 y 19 de octubre de 2026.
Un benchmark sirve si sabemos qué pregunta responde. En nuestra primera comparación queríamos observar compresión, descompresión y dos algoritmos de hashing sobre instancias concretas. No intentábamos certificar proveedores, medir la capacidad de una tienda ni llenar todos los vCPU disponibles.
Esa decisión marca el resto del método. Elegimos trabajos breves, un máximo de dos hilos y prioridad baja porque algunas máquinas tenían servicios activos. El protocolo reduce y acota la carga de la prueba; no garantiza impacto cero. Para ensayar toda la capacidad de un servidor o un checkout completo necesitamos una copia de pruebas y una ventana apropiada.
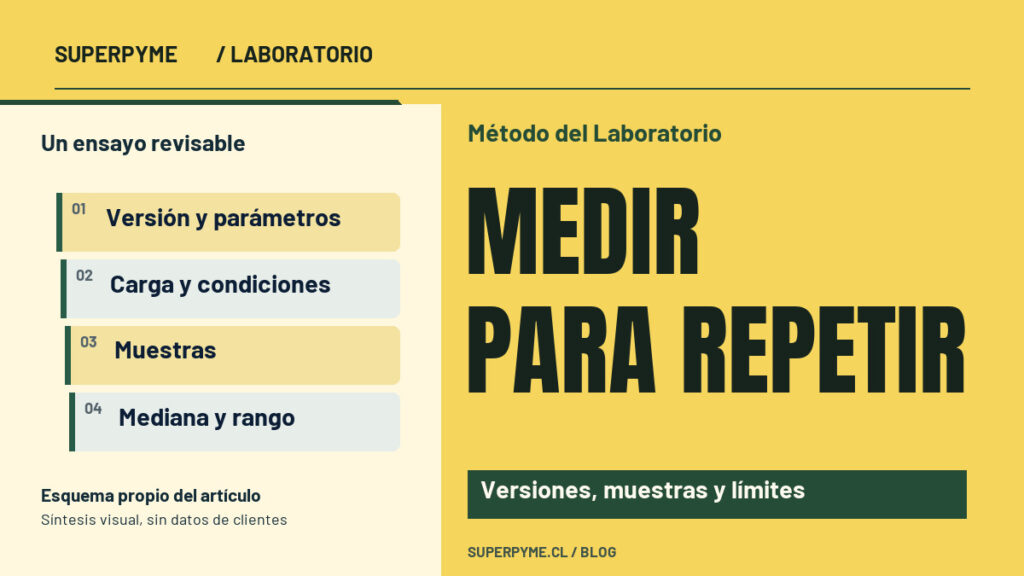
1. Identificar lo que realmente entrega la instancia
Antes de ejecutar trabajo registramos arquitectura, vCPU, memoria visible, sistema operativo, modelo de CPU expuesto y versión de OpenSSL. En un VPS esos datos describen lo que ve el invitado. No prueban el modelo físico del host, su frecuencia sostenida ni si cada vCPU corresponde a un núcleo dedicado.
También guardamos fecha, hora y condiciones iniciales. El mismo equipo puede dar resultados distintos con otras tareas activas o en otro momento. No añadimos contraseñas, direcciones IP, nombres internos o credenciales al conjunto público. Las capturas originales quedan en un archivo privado y los datos del artículo usan etiquetas comprensibles.
2. Fijar versión, origen y parámetros
Usamos las distribuciones oficiales de 7-Zip 26.03 para ARM64 y x86_64. Antes de ejecutar comprobamos el SHA-256 del archivo descargado. Son binarios distintos para cada arquitectura, de la misma versión y con los mismos parámetros; no afirmamos que sus compilaciones o rutas de ejecución sean idénticas.
7zz b 1 -mmt1 -md22
7zz b 1 -mmt2 -md22
El diccionario es de 4 MiB. Repetimos cada configuración tres veces, alternando uno y dos hilos. Conservamos las velocidades de compresión y descompresión por separado. No multiplicamos el resultado de dos hilos por ocho para proyectar dieciséis: la organización del trabajo del compresor y los recursos compartidos pueden cambiar el comportamiento.
Para hashing usamos OpenSSL EVP con bloques de 16 384 bytes y dos segundos por muestra:
openssl speed -elapsed -seconds 2 -bytes 16384 -evp sha256
openssl speed -elapsed -seconds 2 -bytes 16384 -evp sha512
Repetimos tres veces cada algoritmo. La opción -elapsed utiliza tiempo transcurrido. Las versiones de OpenSSL difieren entre algunas máquinas, de modo que estos resultados comparan los runtimes entregados, incluidas sus bibliotecas e instrucciones disponibles. Para aislar ese factor haría falta otro experimento.
3. Comprobar carga antes de cada trabajo
El script exige al menos 2 GiB de memoria disponible, una muestra de CPU ocupada de hasta el 60 % y una carga de un minuto dividida por los vCPU de hasta 0,65. Si una puerta falla, el resultado queda parcial. No se eleva el umbral automáticamente para obtener una cifra.
Ejecutamos con nice 19 y limitamos el espacio de direcciones a 512 MiB. La prioridad baja ayuda al planificador a favorecer otras tareas, pero no es una reserva de CPU ni de memoria y no equivale a un límite global del host. La máquina puede tener procesos ajenos al benchmark que consuman recursos mientras medimos.
Comparamos el contador OOM anterior y posterior y retiramos el directorio temporal del binario al terminar. Si el contador aumenta, no aceptamos la corrida como completa. Que no aumente tampoco demuestra por sí solo que las aplicaciones conservaron su latencia: para afirmar eso necesitaríamos telemetría de las propias aplicaciones.
4. Publicar las muestras, la mediana y el rango
La mediana de tres valores es el valor intermedio al ordenarlos. Nos permite resumir cada configuración sin elegir deliberadamente la muestra más favorable. Publicamos también mínimo y máximo. Esas barras muestran la dispersión observada, no un intervalo de confianza estadístico ni un acuerdo de nivel de servicio.
Para LZMA partimos de KiB/s y dividimos por 1 024 para mostrar MiB/s. Para hashing dividimos bytes por segundo entre un millón para mostrar MB/s. Cada gráfico mantiene su propia unidad y arranca en cero. Una diferencia pequeña con rangos solapados merece una lectura prudente; tres muestras no establecen una ventaja estable.
5. Añadir nuevas mediciones sin borrar las anteriores
Cada experimento conserva un identificador, una versión de método, fechas y estado editorial. Una instancia retirada sigue en el histórico. Una corrida parcial no entra silenciosamente al ranking y una repetición posterior crea una observación nueva. Si cambiamos versión de 7-Zip, tamaño de diccionario, duración o concurrencia, registramos el cambio y abrimos otra serie comparable.
El script revisable del protocolo no instala paquetes del sistema ni cambia servicios. Su ejecución exige autorización del propietario y la opción explícita --run. Produce un archivo privado nuevo, sin sobrescribir otro. Antes de incorporarlo al material público revisamos sus etiquetas y su contenido.
Este método nos deja un punto de partida verificable. El siguiente nivel será medir una aplicación representativa sobre datos de prueba, registrar latencias y errores bajo concurrencia y contrastar el resultado con el coste total verificado. No hace falta prometer ese resultado antes de medirlo.
Revisa las 60 muestras de la primera comparación y cómo las interpretamos. Son 30 muestras de LZMA y 30 de hashing.
Documentación primaria: versión oficial de 7-Zip y opciones de OpenSSL speed.
Siguiente paso recomendado
Convierte lo aprendido en un sitio que genere oportunidades
Cuéntanos qué debe lograr tu web, qué contenido ya tienes y cuál es el siguiente paso que esperas de tus visitantes.
Compartimos guías claras para que tu pyme tome mejores decisiones digitales.