Volver al Laboratorio · Laboratorio / Experimentos / Experimento 01
Nuestro AMD ganó en compresión y SHA-512; un ARM lideró SHA-256. La diferencia explica por qué conviene relacionar cada benchmark con el trabajo que hará tu aplicación.
Resultados propios del 18 y 19 de octubre de 2026. Hasta dos hilos en LZMA y un proceso en hashing.
Imagina que comparas servidores para una aplicación y encuentras dos tablas. En una gana un AMD; en otra, un ARM. Antes de atribuir la diferencia al marketing, conviene mirar qué se está ejecutando. Una cifra de compresión y una cifra de SHA-256 describen operaciones distintas. El ganador puede cambiar sin que ninguna tabla esté necesariamente equivocada.
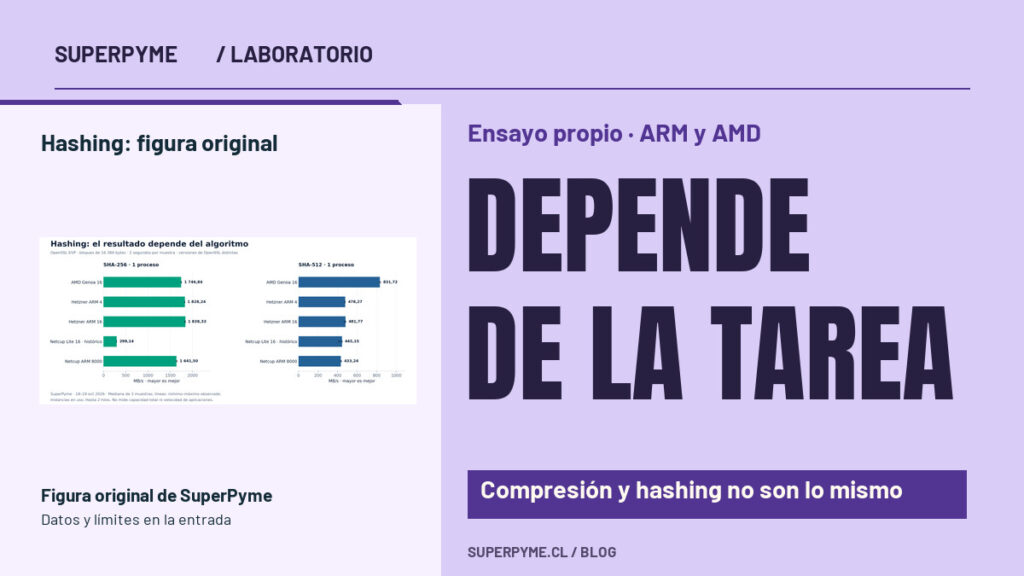
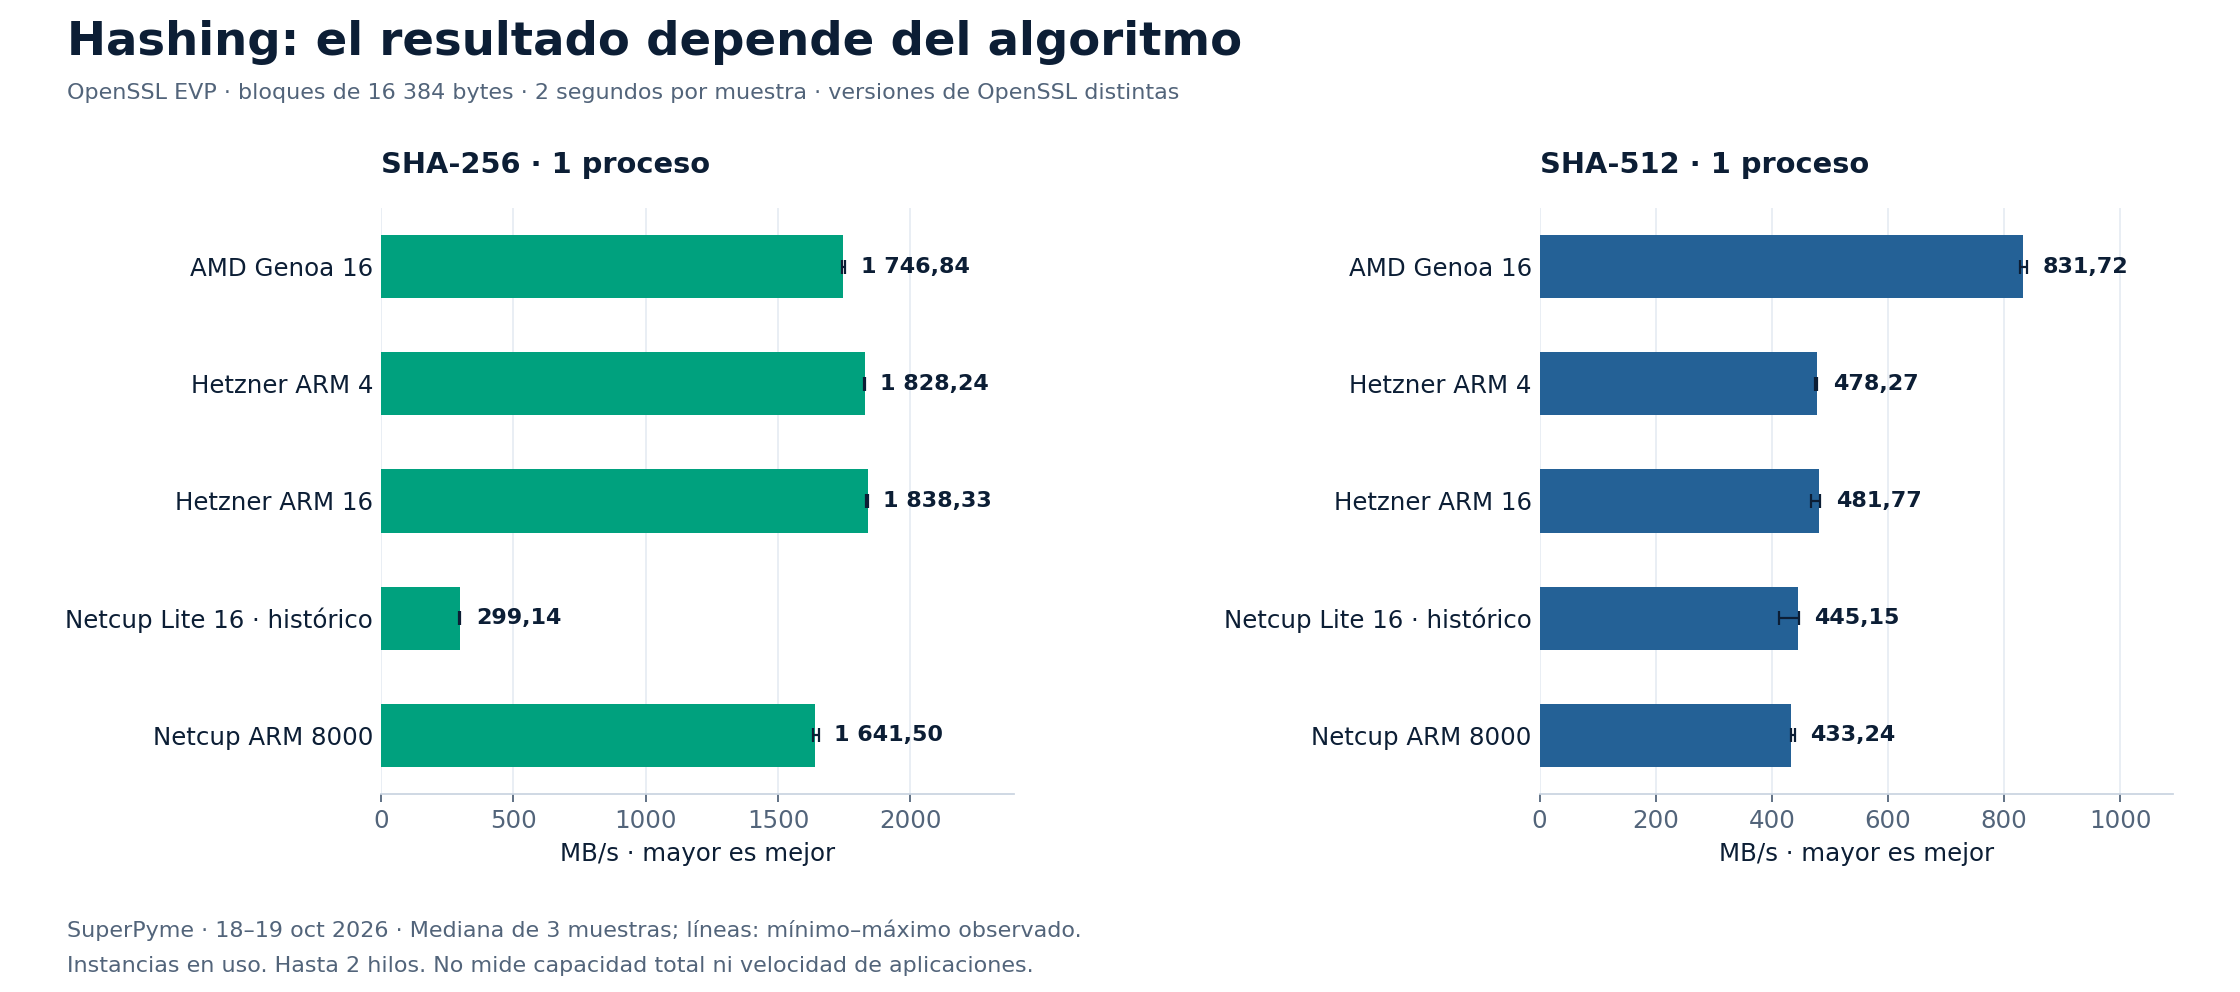
Eso ocurrió en nuestra comparación de cinco instancias. El AMD EPYC Genoa de 16 vCPU administrado con RunCloud tuvo la mayor mediana de compresión LZMA con uno y dos hilos: 4,82 y 14,06 MiB/s. El ARM principal de Hetzner encabezó SHA-256 con 1 838,33 MB/s. En SHA-512, el AMD volvió a liderar, con 831,72 MB/s.
Una arquitectura no es una puntuación
ARM64 y x86_64 describen arquitecturas. Dentro de cada una existen procesadores, generaciones, configuraciones y formas de virtualización diferentes. En nuestro conjunto, los ARM exponían Neoverse N1, el AMD exponía EPYC Genoa y el Netcup Lite mostraba un modelo genérico de QEMU. No son cinco muestras equivalentes de dos arquitecturas puras.
El entorno que entrega un proveedor incluye más factores que el nombre del procesador: recursos compartidos, instrucciones expuestas, memoria y bibliotecas. Los resultados de una instancia concreta ayudan a decidir sobre esa instancia. Una sola máquina no permite sentenciar el rendimiento de toda una empresa ni de todos los chips que comparten arquitectura.
Compresión y hashing siguen caminos diferentes
El benchmark LZMA procesa su propio trabajo de compresión y descompresión. En hashing, OpenSSL selecciona implementaciones disponibles para el algoritmo solicitado. Instrucciones especializadas y bibliotecas pueden influir mucho en el segundo caso. Para aislar cuánto aporta cada factor necesitaríamos controlar explícitamente esas implementaciones y repetir el experimento.
El contraste más marcado apareció en SHA-256: el ARM 8000 de Netcup obtuvo 1 641,50 MB/s y el Lite x86, 299,14. Sin embargo, el Lite quedó ligeramente por delante de ese ARM en SHA-512: 445,15 frente a 433,24 MB/s. No extrapolamos una ventaja de un algoritmo a «toda la criptografía».
Más vCPU habla de asignación, no de cada tarea
El ARM pequeño de Hetzner tenía 4 vCPU; el principal, 16. Con dos hilos de LZMA dieron 9,25 y 9,07 MiB/s. No significa que cuatro vCPU puedan atender siempre más trabajo que dieciséis. Solo observamos una tarea que tenía como máximo dos hilos, bajo las condiciones de esas corridas.
Los vCPU restantes no se pusieron a trabajar para medir la capacidad total. Del mismo modo, 62,68 GiB de RAM visibles en el ARM 8000 no aceleran automáticamente un ensayo que usa un diccionario pequeño. La memoria puede ser decisiva cuando la aplicación la necesita, pero esta prueba no midió esa situación.
Incluso el salto de un hilo a dos dentro de 7-Zip debe leerse como dos configuraciones del benchmark. No calculamos una eficiencia lineal de escalado del servidor a partir de ellas. Para conocer la capacidad bajo mucha concurrencia necesitamos diseñar y ejecutar otra prueba.
Relacionar la métrica con una decisión real
Si tu tarea dominante es similar a la compresión medida, el resultado LZMA ofrece una referencia. Si calculas hashes de grandes bloques, las pruebas de OpenSSL pueden orientar una pregunta más específica. Una aplicación web, en cambio, combina lenguaje, base de datos, caché, disco, red y dependencias externas. Su tiempo de respuesta no se deduce de convertir MiB/s a una supuesta cantidad de visitantes.
Antes de migrar también hay que comprobar compatibilidad: imágenes de contenedores, módulos nativos, extensiones y herramientas que realmente utiliza el proyecto. Tener una etiqueta ARM en un plan no acredita que una imagen propia esté disponible para esa arquitectura. En esta serie no hemos validado ni migrado aplicaciones para probar esa compatibilidad.
Qué nos llevamos al próximo experimento
Elegiremos una aplicación representativa, prepararemos datos de prueba y mantendremos versiones y configuración comparables. Separaremos una medición sin concurrencia de otra con carga controlada. Registraremos percentiles de latencia, errores y recursos durante la prueba. También necesitaremos precios vigentes y condiciones verificadas para hablar de rendimiento por coste.
Hasta entonces, nuestra conclusión conserva el verbo y el objeto: este AMD comprimió más datos por segundo en nuestro LZMA; este ARM obtuvo la mayor mediana en nuestro SHA-256. Son afirmaciones más útiles que declarar un ganador general y permiten volver dentro de unos meses a comparar una nueva observación con una referencia conocida.
Consulta el protocolo reproducible, las muestras completas y la tabla de las cinco instancias.
Fuentes: mediciones propias; OpenSSL speed; CPU virtual en QEMU; 7-Zip 26.03.
Siguiente paso recomendado
Convierte lo aprendido en un sitio que genere oportunidades
Cuéntanos qué debe lograr tu web, qué contenido ya tienes y cuál es el siguiente paso que esperas de tus visitantes.
Compartimos guías claras para que tu pyme tome mejores decisiones digitales.