Volver al Laboratorio · Laboratorio SuperPyme / Aplicaciones / Chatwoot
En las dos instancias ARM64 probadas, Hetzner respondió más rápido y empleó menos CPU en el control adicional. La RAM máxima muestreada fue muy parecida. Aumentar los trabajadores ayudó a las colas de Netcup, pero no mejoró todas las operaciones por igual.
¿Basta mirar cuántas vCPU y cuánta memoria anuncia un servidor para elegir dónde alojar Chatwoot? La pregunta tiene una consecuencia concreta: una instalación compartida combina procesos web, trabajos de fondo, PostgreSQL y Redis. Más memoria disponible no implica que esa aplicación responda antes, y dar más CPU a un proceso tampoco equivale a iniciar más procesos.
En nuestra comparación de servidores del 19 de octubre publicamos compresión y hashing con un máximo de dos hilos. Aquellas muestras se conservan. No medían Chatwoot y no permiten convertir sus resultados en una cantidad de empresas alojadas. Esta nueva serie añade evidencia de aplicación, con solicitudes HTTP, notificaciones, recursos y colas.
El aporte de esta comparación es mostrar qué cambió al variar los trabajadores y después ampliar conjuntamente los límites de PostgreSQL y Redis. Publicamos las dos repeticiones de cada ajuste, el timeout registrado y el alcance de las notificaciones observadas.
El resultado del control adicional
El control mantuvo cuatro procesos Sidekiq y seis procesos Puma. Se amplió el tope de PostgreSQL a 2 vCPU y el de Redis a 1 vCPU, en ambos servidores. Cada instancia ejecutó dos rondas de 60 segundos nominales de carga y 20 segundos de observación de la cola. Esta tabla combina las respuestas HTTP satisfactorias de ambas rondas.
| Métrica | Netcup ARM 8000 | Hetzner CAX41 | Base del cálculo |
|---|---|---|---|
| Listar conversaciones, p95 | 2,496 s | 0,805 s | 120 respuestas 2xx por host |
| Leer mensajes, p95 | 0,303 s | 0,104 s | 720 respuestas 2xx por host |
| Escribir sin archivo, p95 | 0,810 s | 0,314 s | 336 respuestas 2xx por host |
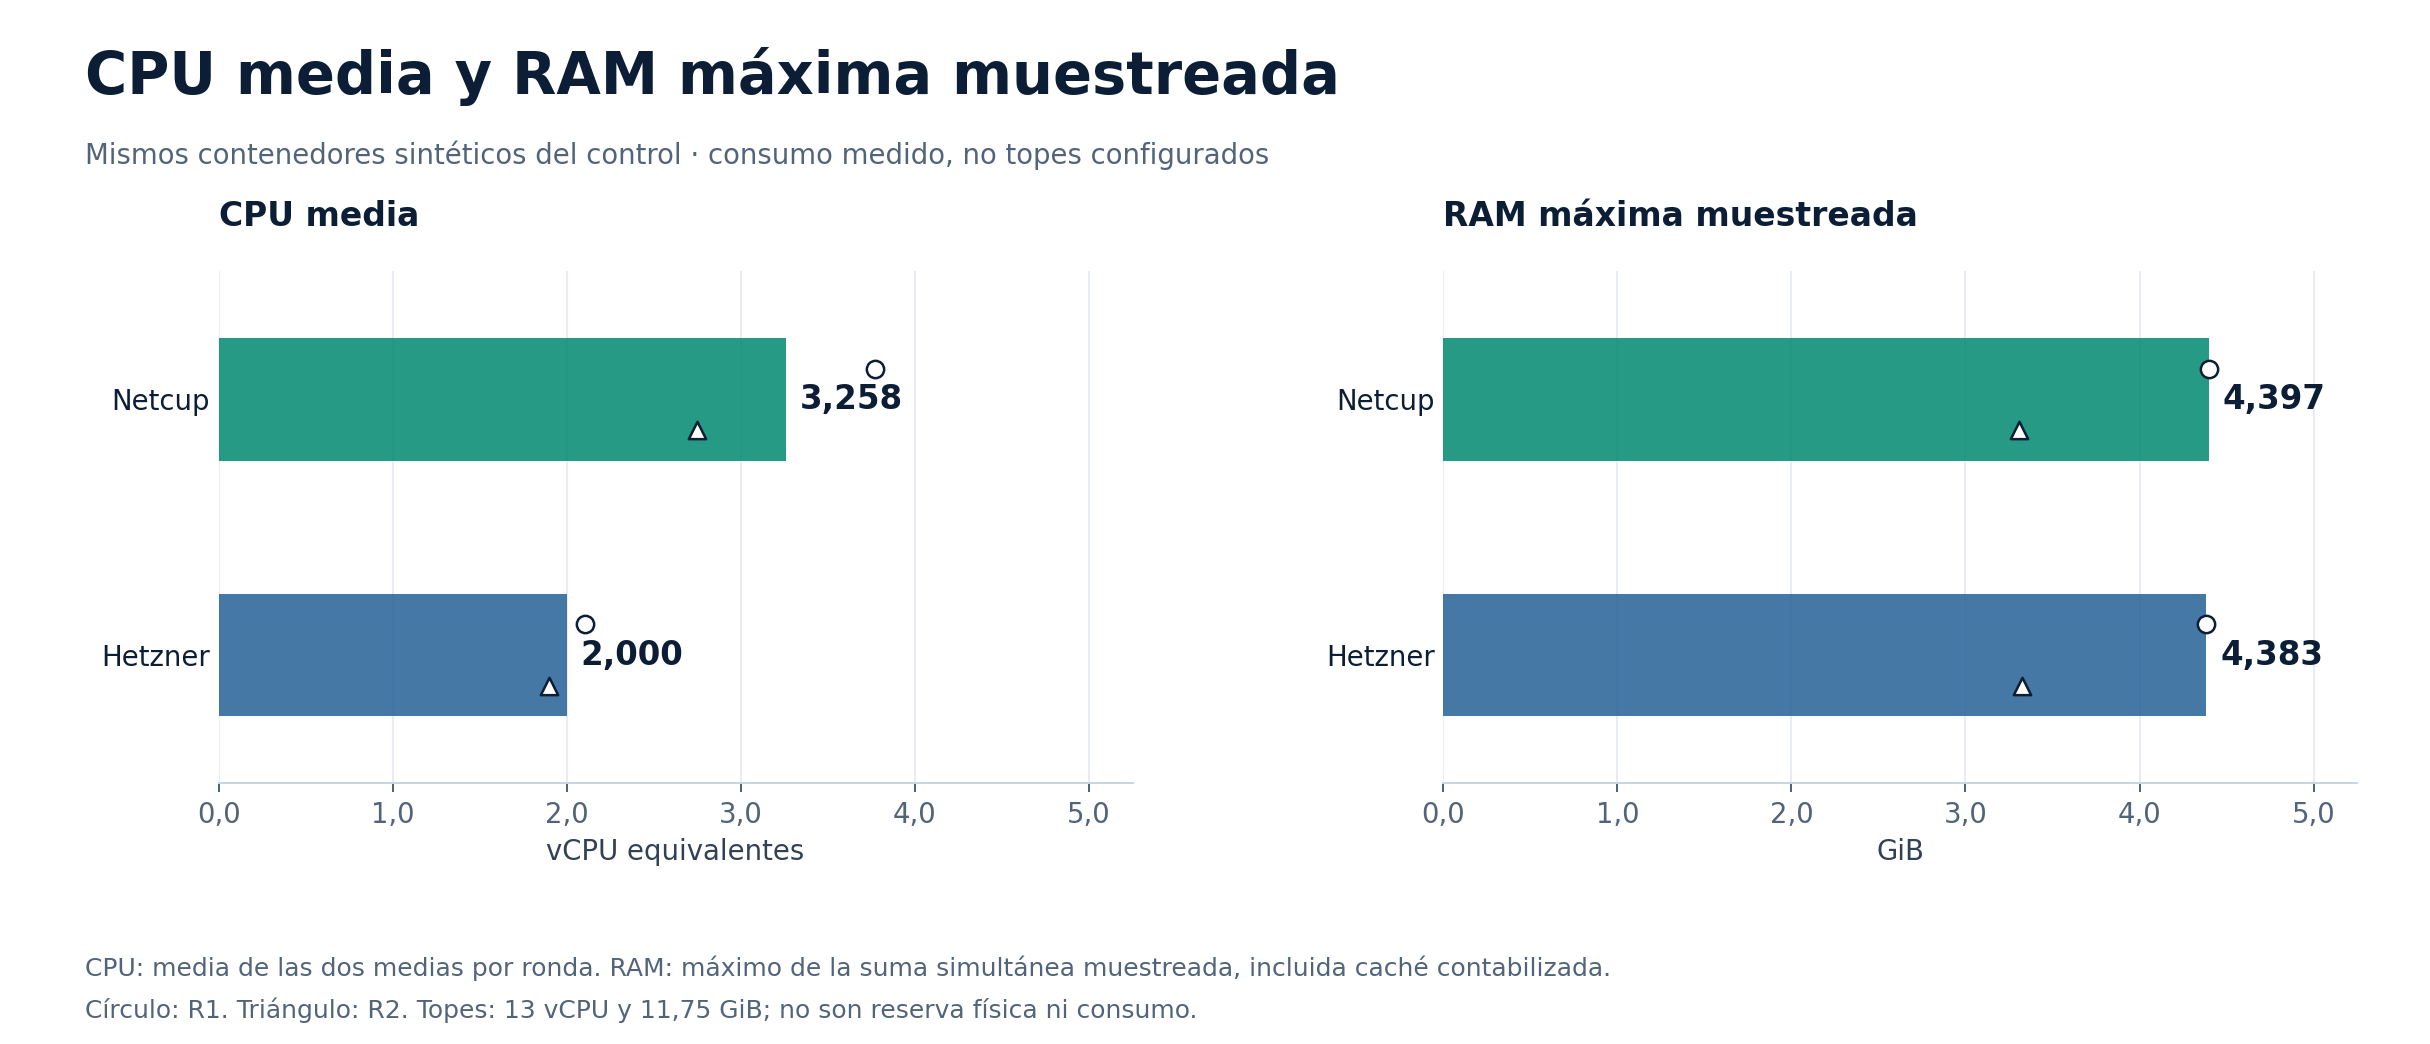
| CPU media muestreada | 3,258 vCPU | 2,000 vCPU | Media de las dos medias por ronda |
| RAM máxima muestreada | 4,397 GiB | 4,383 GiB | Mayor suma simultánea en las muestras |
| Errores HTTP | 0 | 0 | 1.200 solicitudes por host en el control |
| Pendientes tras 20 s de drenaje | 0 | 0 | Máximo entre las dos rondas |
En ese control, Hetzner empleó 38,6 % menos CPU media muestreada que Netcup. Los p95 de listar, leer y escribir fueron entre 61,2 % y 67,7 % menores. Es una reducción de esos tiempos y de ese consumo, no un porcentaje de capacidad total ni una velocidad universal del servidor.
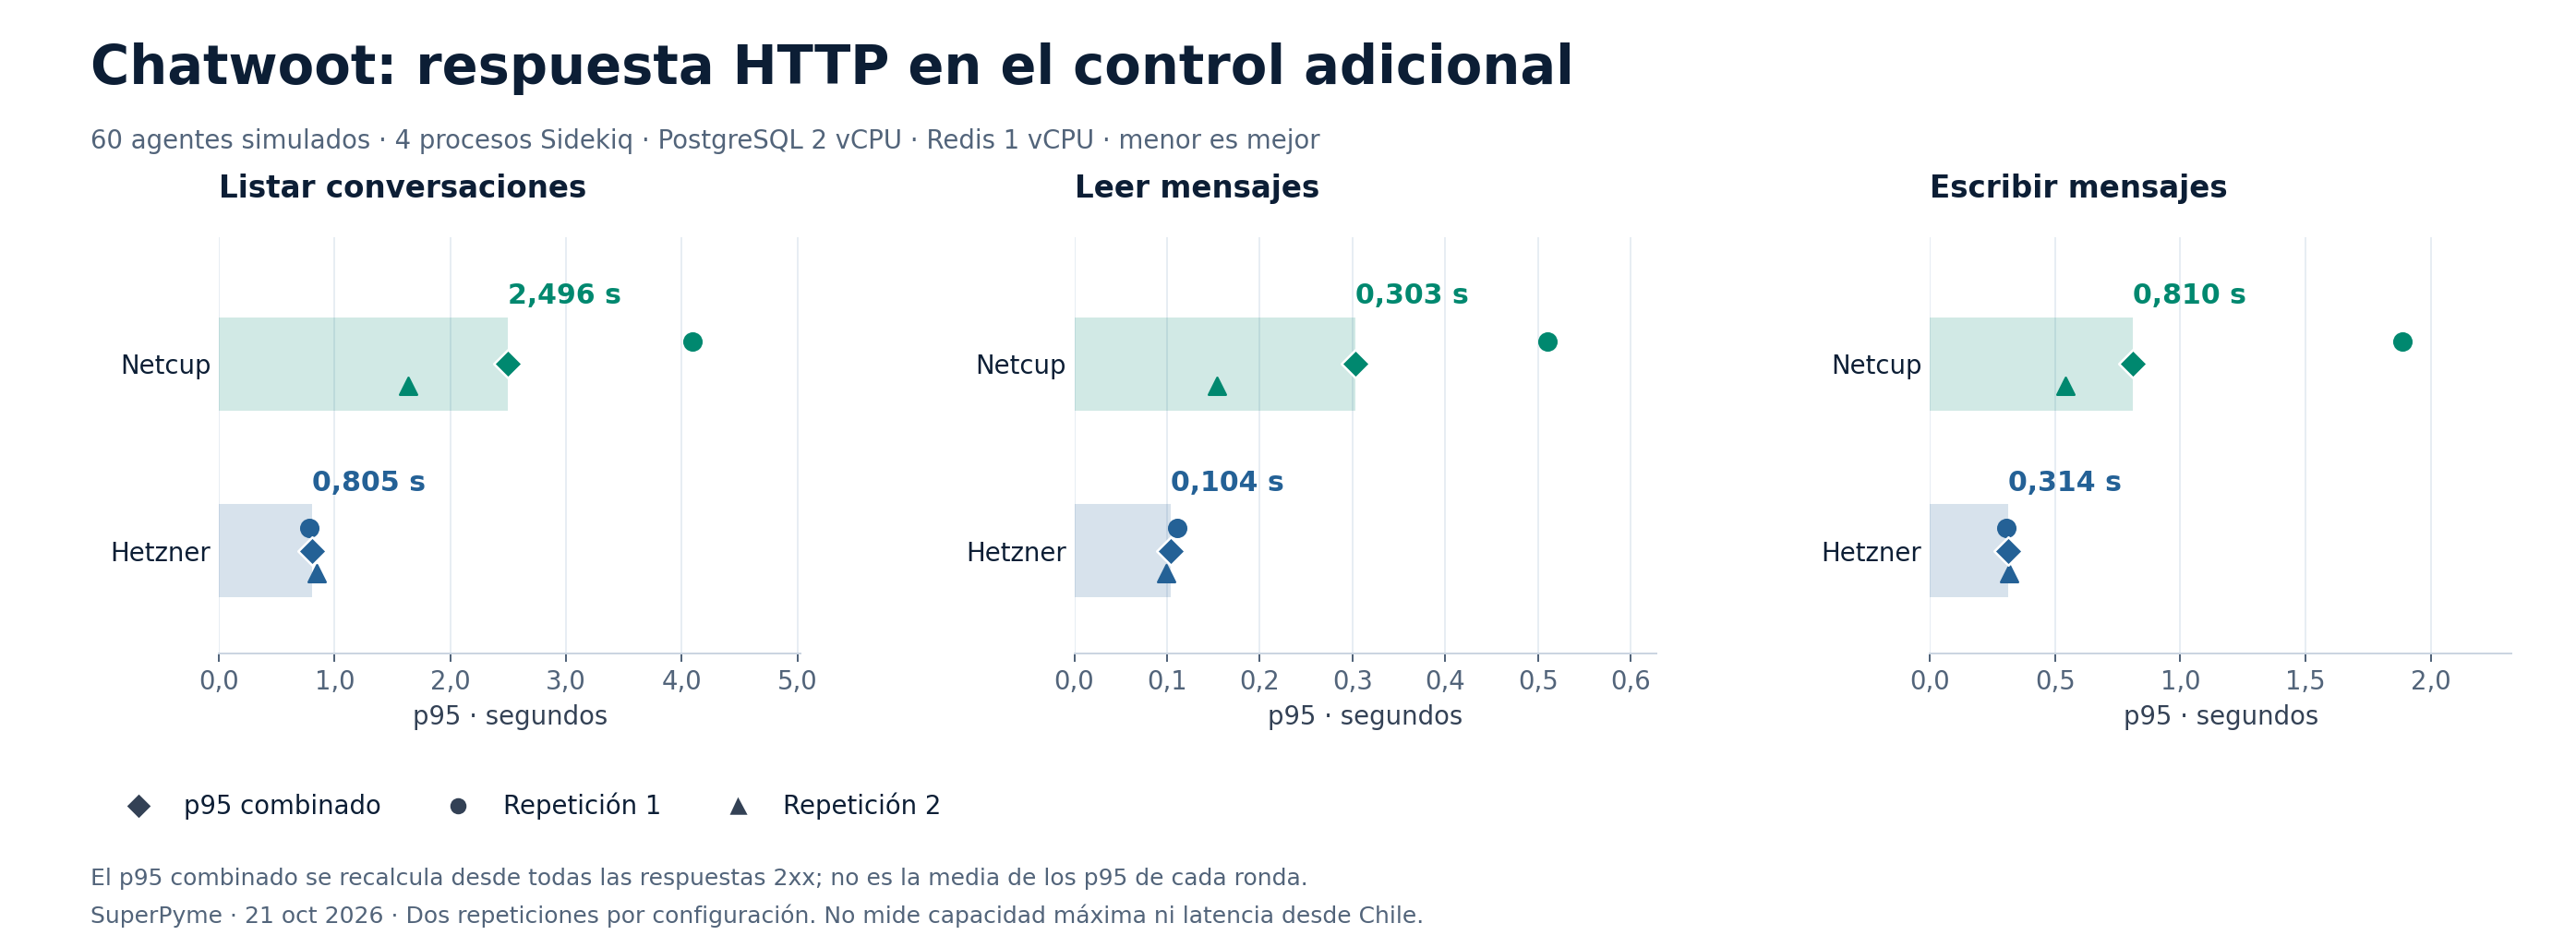
El p95 es un punto de una distribución: aproximadamente el 95 % de las respuestas satisfactorias quedan en ese tiempo o por debajo. No describe la respuesta más lenta. Tampoco incluye el timeout como si hubiera sido una respuesta rápida: los errores se contabilizan aparte.
Dos ARM64 de 16 vCPU, con diferente capacidad de memoria
| Instancia pública | vCPU del invitado | RAM nominal / detectada | Modelo virtual / kernel | Condición de fondo |
|---|---|---|---|---|
| Netcup ARM 8000 | 16 | 64 GB / 62,65 GiB | Neoverse-N1 / 7.0.0-38-generic | Servicios productivos con poca carga de fondo. |
| Hetzner CAX41 | 16 | 32 GB / 30,53 GiB | Neoverse-N1 / 7.0.0-30-generic | Servidor nuevo, sin servicios productivos. |
Ambos invitados reportaban Neoverse-N1. Esto acredita el modelo virtual expuesto al sistema invitado, no la identidad o disponibilidad exclusiva del procesador físico. No es una comparación de ARM frente a AMD. Netcup tenía servicios productivos con poca carga de fondo; Hetzner estaba vacío. Los kernels diferían en revisión. Estas condiciones impiden atribuir toda la diferencia a una sola característica del hardware.
Usamos las mismas imágenes ARM64 de Chatwoot Community 4.18.0, PostgreSQL 16 con pgvector y Redis, fijadas por digest. Las referencias exactas están en el protocolo y datos descargables, ZIP. La CPU y la RAM publicadas pertenecen a los contenedores sintéticos; no suman todas las aplicaciones productivas del host.
| Componente | Procesos e hilos | Tope de CPU | Tope de RAM |
|---|---|---|---|
| Web | 6 procesos Puma; 5 hilos por proceso | 6 vCPU | 3,500 GiB |
| Sidekiq, cada trabajador | 1 proceso; 5 hilos | 1 vCPU | 1,500 GiB |
| PostgreSQL, control | shared_buffers=256MB; max_connections=80 | 2 vCPU | 2,000 GiB |
| Redis, control | maxmemory=192mb; noeviction | 1 vCPU | 0,250 GiB |
| Total con cuatro Sidekiq | Topes sumados, sin reserva física | 13 vCPU | 11,750 GiB |
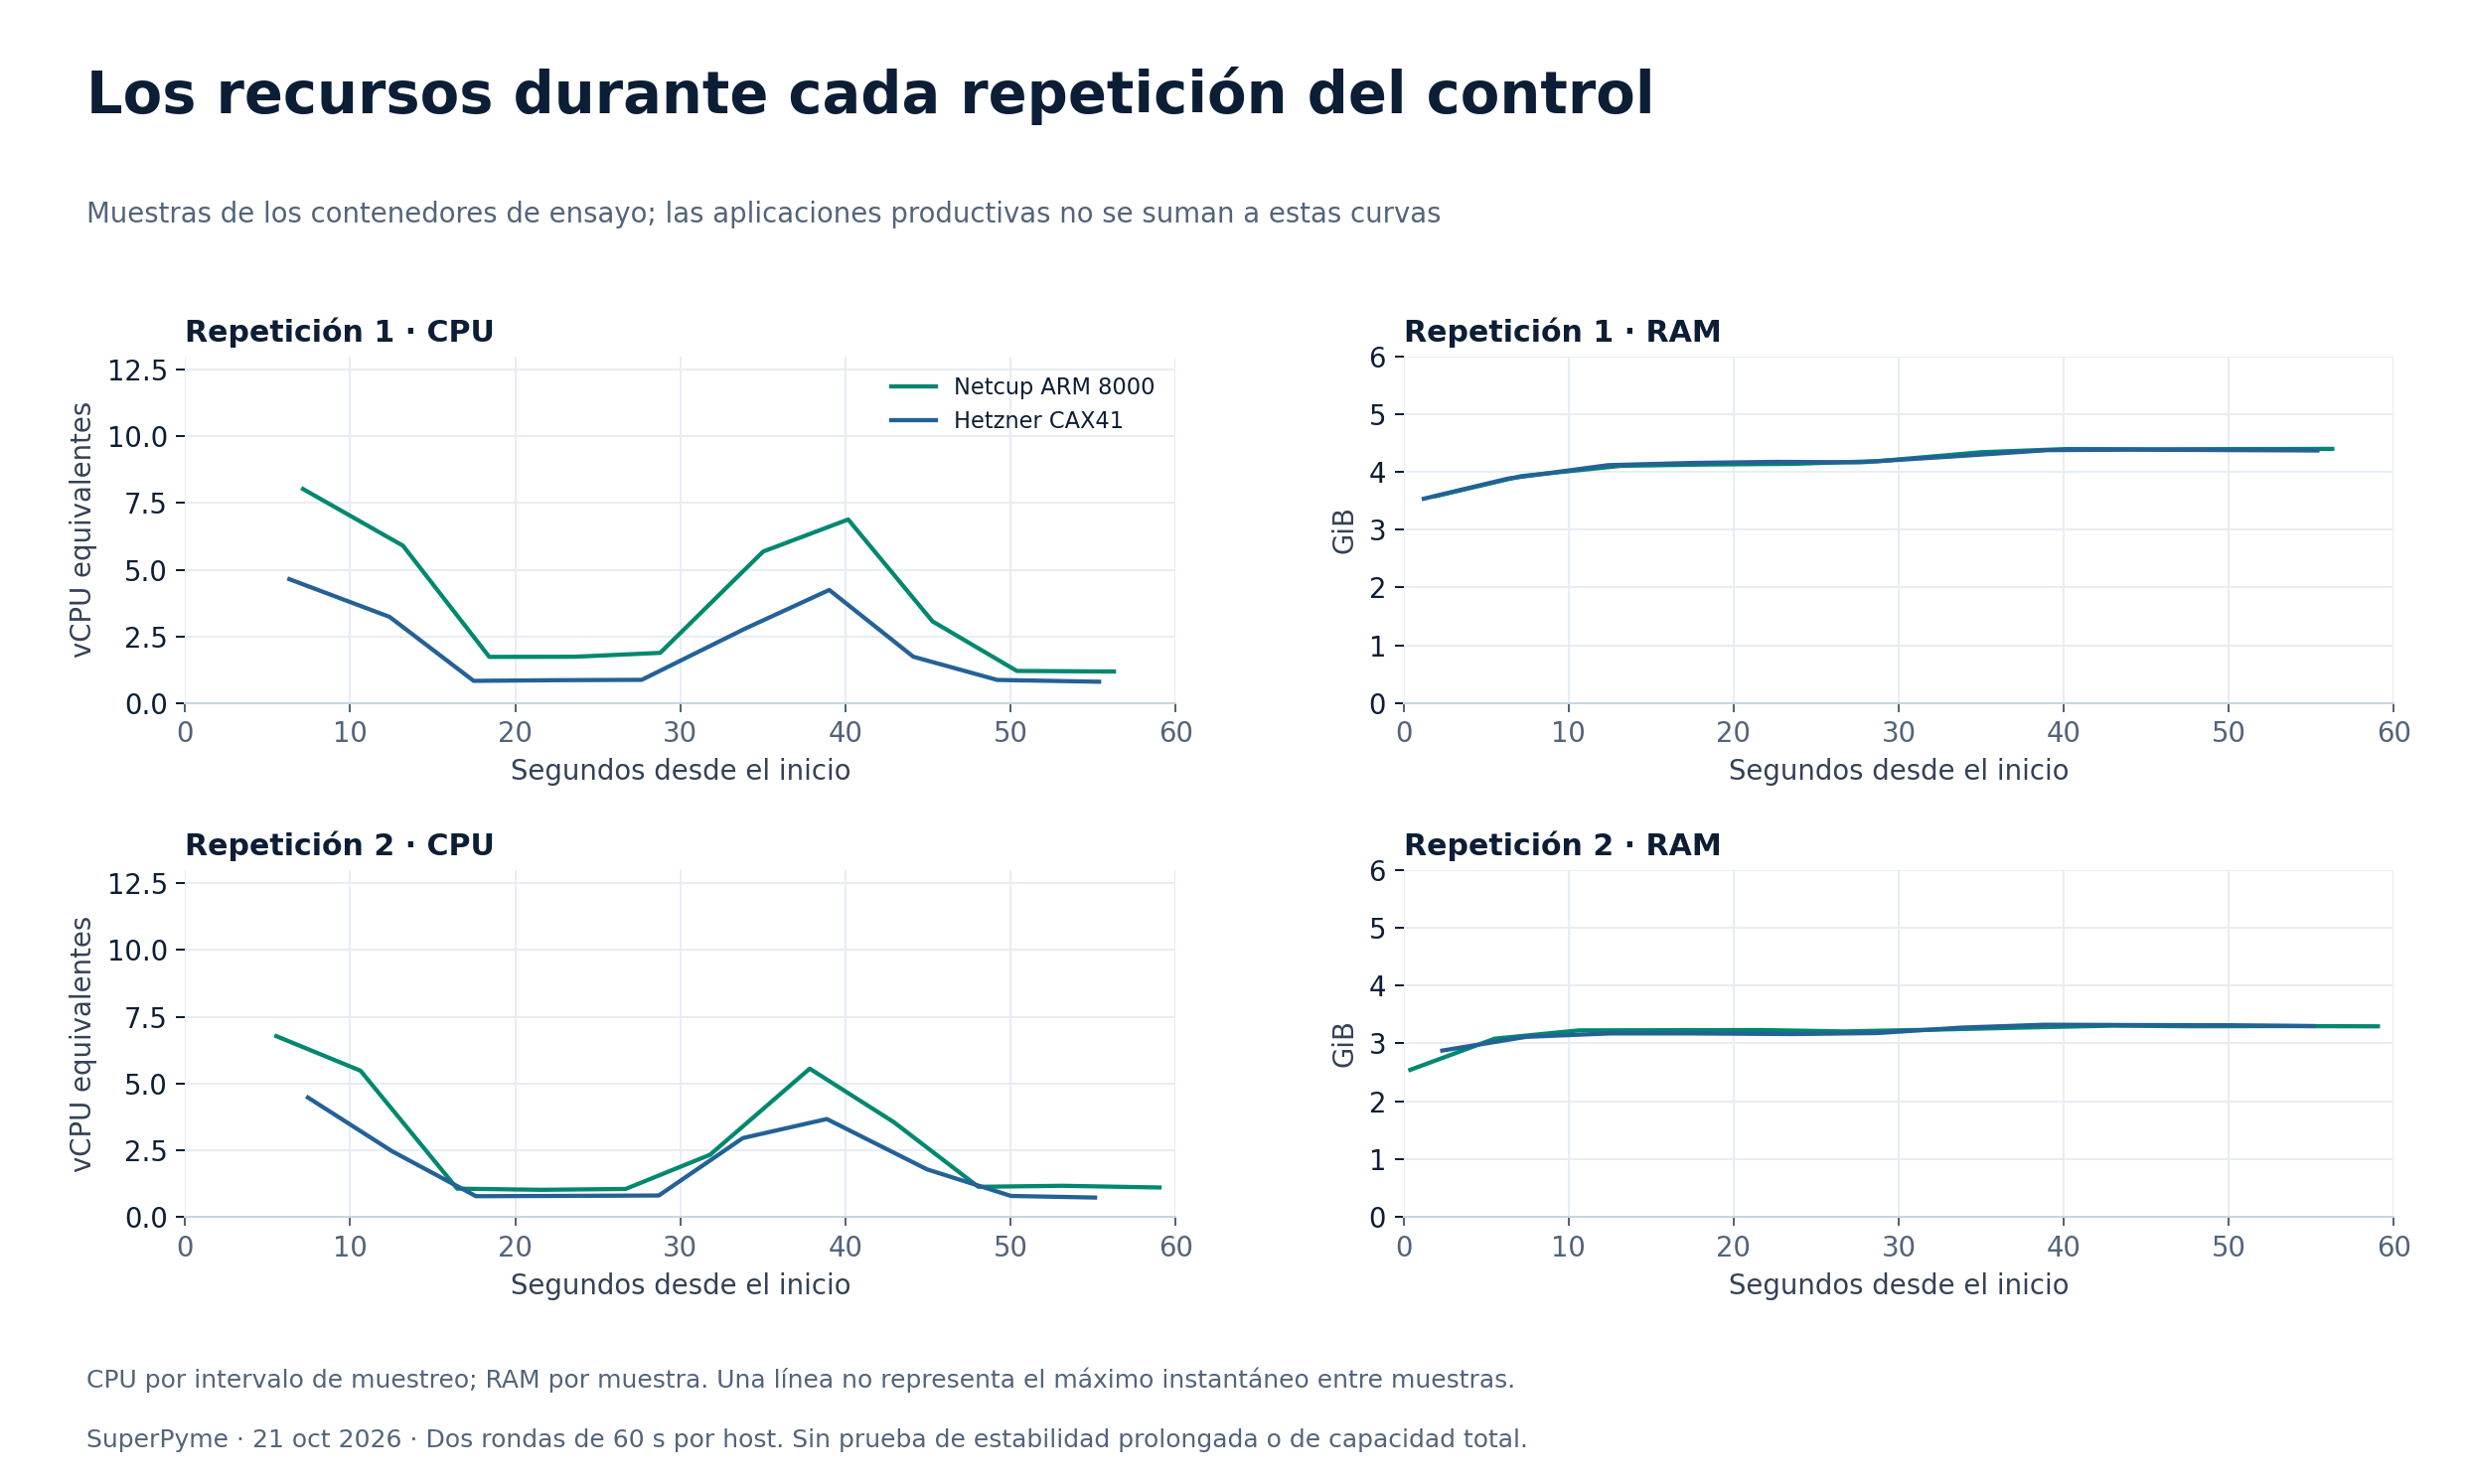
Los topes del control sumaban 13 vCPU y 11,75 GiB. Son límites configurados, no una reserva de núcleos físicos ni el consumo observado. El conjunto consumió aproximadamente 4,4 GiB de RAM como máximo muestreado en ambos equipos. La documentación de cgroup v2 define los contadores de CPU y memoria usados para esta lectura.
La RAM adicional de Netcup seguía siendo capacidad disponible para otras cargas o crecimiento. En este perfil, esa capacidad no se tradujo en una ventaja de respuesta. Esto tampoco demuestra que 32 GB basten para cualquier instalación de Chatwoot.
Qué hicieron los 60 agentes simulados
La base inicial equivalente contenía 10 cuentas sintéticas, 60 agentes, 10.000 conversaciones y 50.000 mensajes históricos. Cada ronda comenzó desde una restauración de esa base y un Redis de ensayo limpio, después del calentamiento previsto. No se utilizaron conversaciones ni datos de clientes.
El generador se ejecutó dentro de cada host. Los 60 agentes iniciaban su actividad repartidos en los primeros diez segundos y seguían ciclos de diez segundos. Cada uno rotaba sobre seis conversaciones de la base, leía mensajes y escribía en los ciclos previstos. El listado consultaba la primera página con una fase distribuida; no se recorría uniformemente todo el histórico. Parte de las escrituras incorporaba un archivo sintético de 2 MiB; la mitad de los agentes que recibían el mensaje de prueba esperaba 200 ms y respondía por API como un bot determinista.
Registramos 600 solicitudes del perfil por ronda: 60 listados, 360 lecturas, 168 escrituras sin archivo y 12 adjuntos. En ocho rondas por host sumaron 4.800 solicitudes por servidor y 9.600 entre ambos. El conteo no incluye las comprobaciones de salud, la preparación de datos o los intercambios de conexión de ActionCable.
La duración es nominal. El generador dejaba de iniciar ciclos a los 60 segundos, pero completaba la secuencia que ya había comenzado. Por eso algunas solicitudes terminaron después: el último cierre HTTP registrado fue aproximadamente a los 61,25 segundos. Conservamos todas esas solicitudes; CPU y RAM usan las muestras dentro de la ventana nominal, con su cobertura indicada. El detalle por ronda incluye su último final HTTP.
El agente espera la respuesta antes de continuar su secuencia. Es un perfil interactivo temporizado, no una llegada abierta independiente de la latencia. El número de agentes virtuales no equivale al número de empresas que puede atender un servidor. El bot tampoco representa inferencia de IA, Meta, correo o entrega de webhooks externos.
Más trabajadores mejoraron las colas, pero no todo el HTTP
La serie inicial recorrió 1, 2, 4, 4, 2 y 1 procesos Sidekiq por host. Cada proceso tuvo cinco hilos y un tope de 1 vCPU. Web permaneció en seis procesos Puma, cinco hilos y un límite de 6 vCPU. PostgreSQL se limitó a 0,75 vCPU y Redis a 0,25 vCPU.
| Instancia y ajuste | Listar p95 | Leer p95 | Escribir p95 | Adjunto p95 | CPU media, vCPU | RAM máx., GiB | Errores HTTP | Pendientes |
|---|---|---|---|---|---|---|---|---|
| Netcup ARM 8000 · 1 proceso · serie inicial | 2,836 s | 0,434 s | 1,228 s | 2,010 s | 3,789 | 2,680 | 0 | 447 |
| Netcup ARM 8000 · 2 procesos · serie inicial | 6,030 s | 0,611 s | 1,674 s | 4,945 s | 3,928 | 2,800 | 0 | 0 |
| Netcup ARM 8000 · 4 procesos · serie inicial | 7,250 s | 1,068 s | 2,650 s | 5,881 s | 4,053 | 3,746 | 1 | 0 |
| Netcup ARM 8000 · 4 procesos · control DB/Redis | 2,496 s | 0,303 s | 0,810 s | 5,269 s | 3,258 | 4,397 | 0 | 0 |
| Hetzner CAX41 · 1 proceso · serie inicial | 0,860 s | 0,112 s | 0,354 s | 0,404 s | 2,069 | 2,649 | 0 | 0 |
| Hetzner CAX41 · 2 procesos · serie inicial | 0,820 s | 0,098 s | 0,308 s | 0,416 s | 1,959 | 2,641 | 0 | 0 |
| Hetzner CAX41 · 4 procesos · serie inicial | 0,775 s | 0,096 s | 0,296 s | 0,489 s | 1,726 | 3,677 | 0 | 0 |
| Hetzner CAX41 · 4 procesos · control DB/Redis | 0,805 s | 0,104 s | 0,314 s | 0,310 s | 2,000 | 4,383 | 0 | 0 |
En Netcup, el p95 combinado de listado subió de 2,836 s con un trabajador a 7,250 s con cuatro bajo esos límites de base de datos y Redis. A la vez, las notificaciones mejoraron y la cola se redujo: una de las rondas con un trabajador conservó 447 trabajos pendientes después del drenaje; con cuatro no quedaron trabajos pendientes al terminar esa observación.
Ese contraste es parte del resultado. Añadir procesos no produjo una mejora uniforme. La documentación de configuración de Chatwoot describe cómo procesos web, concurrencia de Sidekiq y conexiones a la base de datos deben ajustarse conjuntamente. Dar cuatro vCPU a un único proceso no es la misma configuración que ejecutar cuatro procesos con un tope de una vCPU cada uno.
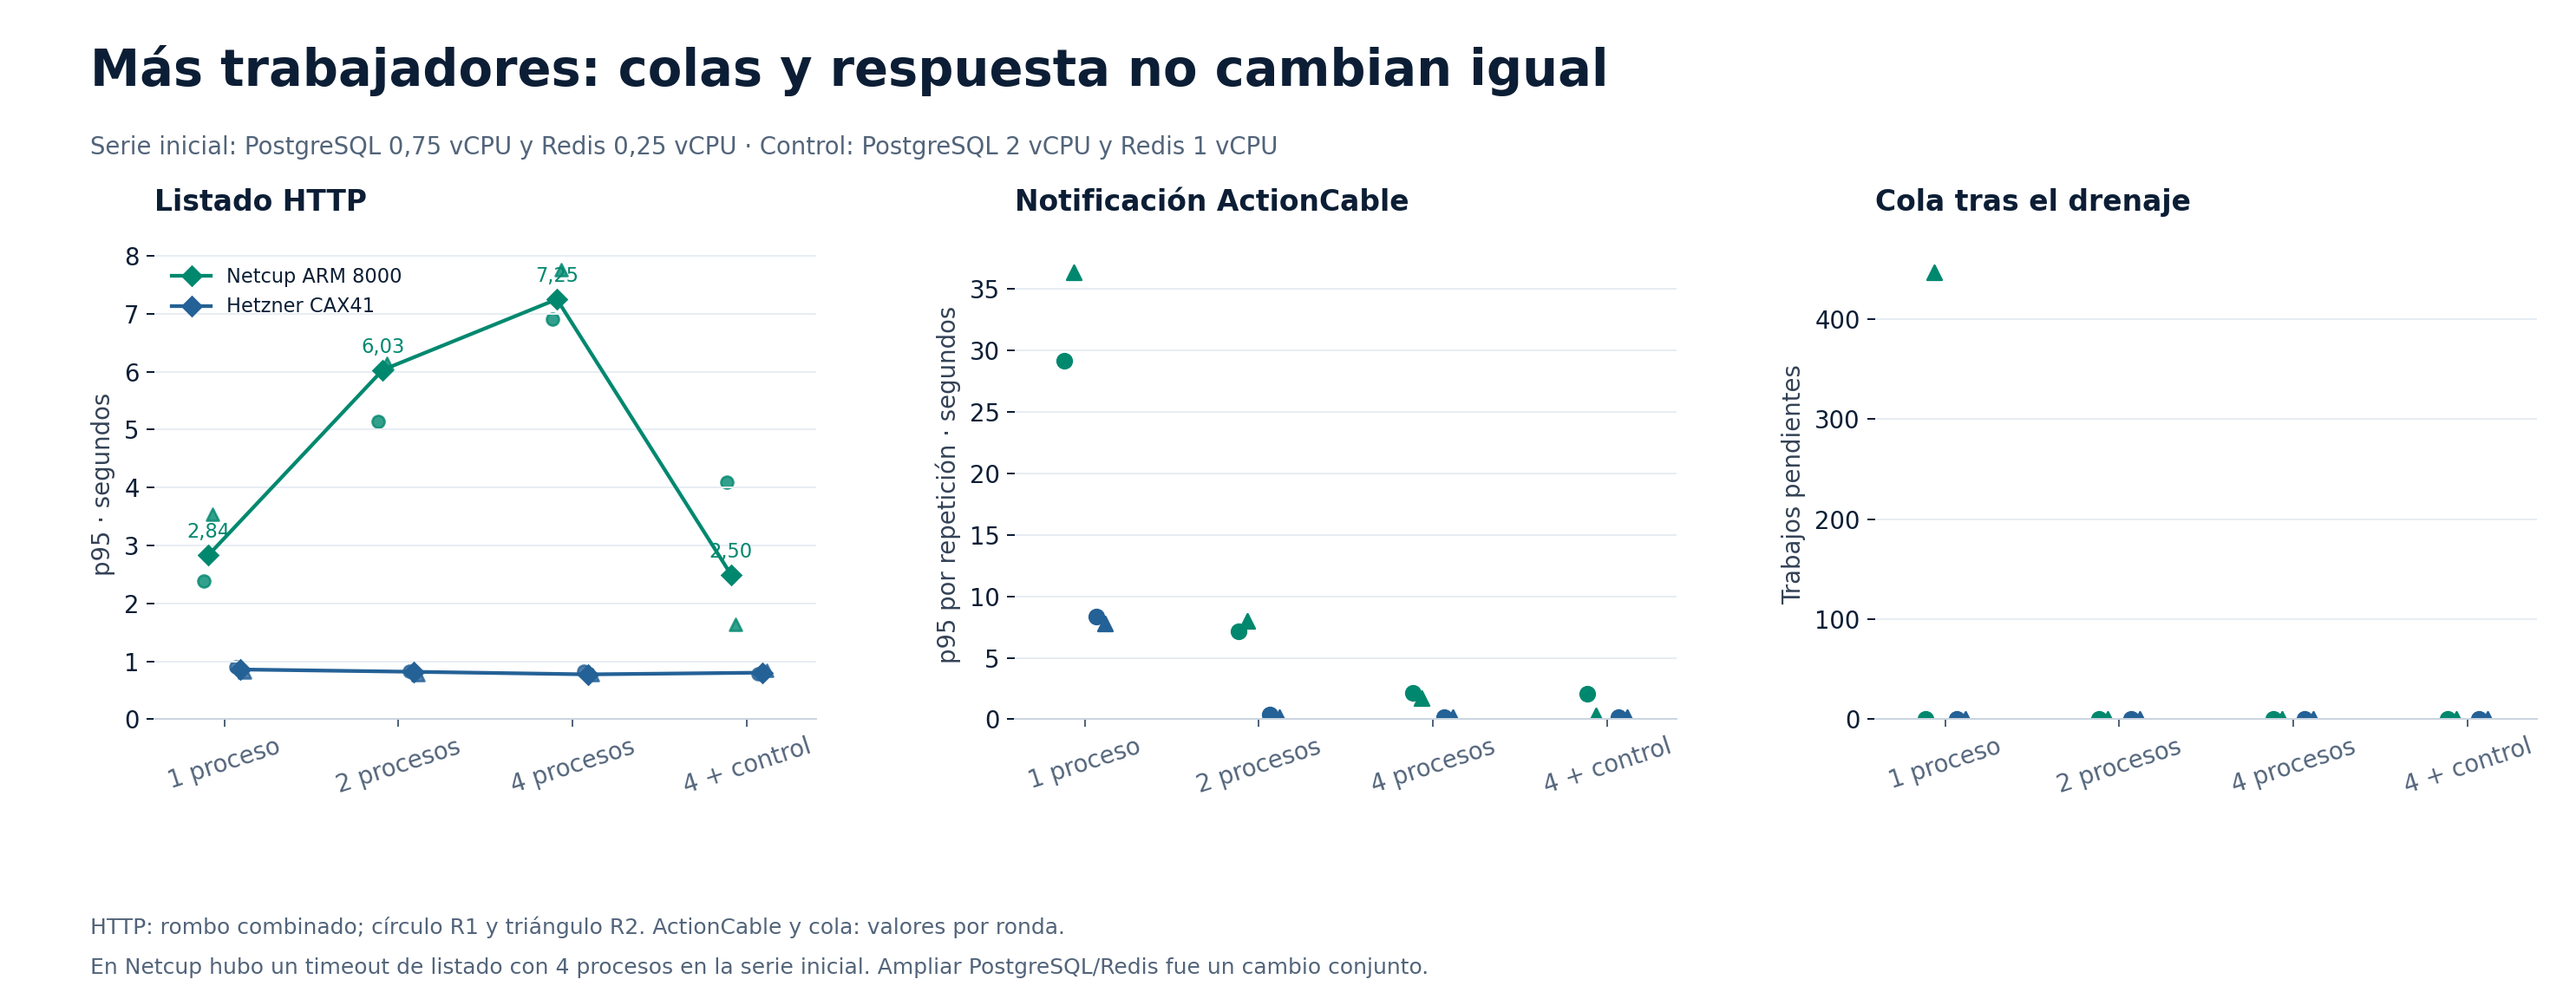
Después hicimos el control de cuatro trabajadores ampliando PostgreSQL de 0,75 a 2 vCPU y Redis de 0,25 a 1 vCPU. El p95 de listado de Netcup bajó a 2,496 s. Cambiaron dos límites a la vez, en una serie posterior: no aislamos cuánto del efecto corresponde a PostgreSQL, a Redis o a las condiciones de esa ronda.
En Hetzner, el listado ya se mantenía por debajo de un segundo de p95 combinado en las configuraciones iniciales. El control no mejoró todas sus métricas respecto a la configuración anterior. Tampoco debe presentarse como un ajuste óptimo definitivo para cualquier base de datos o instalación.
Las repeticiones y las notificaciones cambian la interpretación
En las dos rondas del control, el p95 de listado de Netcup fue 4,090 s y 1,631 s; en Hetzner, 0,783 s y 0,841 s. El combinado fue 2,496 s y 0,805 s respectivamente. El p95 combinado no es la media de esos p95: lo recalculamos desde las respuestas individuales de ambas rondas, con rango más próximo ceil(0,95 × n).
| Instancia / ronda | Listar p95 | Leer p95 | Escribir p95 | CPU media, vCPU | RAM máx., GiB |
|---|---|---|---|---|---|
| Netcup ARM 8000 · R1 | 4,090 s | 0,510 s | 1,888 s | 3,771 | 4,397 |
| Netcup ARM 8000 · R2 | 1,631 s | 0,153 s | 0,541 s | 2,745 | 3,305 |
| Hetzner CAX41 · R1 | 0,783 s | 0,111 s | 0,305 s | 2,102 | 4,383 |
| Hetzner CAX41 · R2 | 0,841 s | 0,099 s | 0,317 s | 1,898 | 3,322 |
Hubo un timeout de listado en Netcup, en la segunda ronda de cuatro trabajadores de la serie inicial. El control adicional registró cero errores HTTP en ambos hosts. La ausencia de errores HTTP en ese control no certifica entrega perfecta de eventos ni corrección completa de todos los canales reales.
| Instancia y ajuste | p95 de eventos por ronda | Eventos observados / previstos | Pendientes después del drenaje |
|---|---|---|---|
| Netcup ARM 8000 · 1 proceso · serie inicial | 29,176 s a 36,386 s | 236 / 240 | 447 |
| Netcup ARM 8000 · 2 procesos · serie inicial | 7,137 s a 7,968 s | 240 / 240 | 0 |
| Netcup ARM 8000 · 4 procesos · serie inicial | 1,749 s a 2,137 s | 239 / 240 | 0 |
| Netcup ARM 8000 · 4 procesos · control DB/Redis | 0,319 s a 2,105 s | 238 / 240 | 0 |
| Hetzner CAX41 · 1 proceso · serie inicial | 7,796 s a 8,351 s | 239 / 240 | 0 |
| Hetzner CAX41 · 2 procesos · serie inicial | 0,202 s a 0,356 s | 240 / 240 | 0 |
| Hetzner CAX41 · 4 procesos · serie inicial | 0,165 s a 0,175 s | 240 / 240 | 0 |
| Hetzner CAX41 · 4 procesos · control DB/Redis | 0,142 s a 0,144 s | 239 / 240 | 0 |
Durante el control se observaron 238 de 240 eventos previstos en Netcup y 239 de 240 en Hetzner dentro de las ventanas registradas. El p95 de ActionCable varió entre 0,319 y 2,105 s en Netcup, frente a 0,142 y 0,144 s en Hetzner. Estos percentiles se conservan por ronda: no disponemos de sus duraciones individuales para combinarlos. Un evento previsto no observado en ventana no prueba por sí solo la pérdida de un mensaje persistido.
| Instancia | Muestras de adjuntos | p95 R1 | p95 R2 | p95 combinado |
|---|---|---|---|---|
| Netcup ARM 8000 | 24 | 6,459 s | 0,739 s | 5,269 s |
| Hetzner CAX41 | 24 | 0,310 s | 0,758 s | 0,310 s |
Los adjuntos del control tienen solo 24 muestras por host. Su p95 combinado fue 5,269 s en Netcup y 0,310 s en Hetzner. Los incluimos para conservar el resultado completo, pero esa cola de pocos archivos no será un titular universal sobre almacenamiento, subidas desde clientes o rendimiento de red.
Ver las 16 rondas, sus errores y el consumo muestreado
| Instancia / serie / orden | Sidekiq | Ronda | Listar p95 | CPU media, vCPU | RAM máx., GiB | Steal del host | Muestras / cobertura | Fin HTTP relativo | Errores | Eventos | Pendientes |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Netcup ARM 8000 · inicial · 1 | 1 | 1 | 2,386 s | 3,611 | 2,680 | 4,69 % | 12 / 58,3 s | 61,25 s | 0 | 119/120 | 0 |
| Netcup ARM 8000 · inicial · 2 | 2 | 1 | 5,144 s | 3,745 | 2,800 | 4,79 % | 11 / 53,7 s | 61,01 s | 0 | 120/120 | 0 |
| Netcup ARM 8000 · inicial · 3 | 4 | 1 | 6,906 s | 4,031 | 3,746 | 4,47 % | 11 / 55,1 s | 61,12 s | 0 | 120/120 | 0 |
| Netcup ARM 8000 · inicial · 4 | 4 | 2 | 7,755 s | 4,075 | 3,409 | 4,53 % | 11 / 54,9 s | 61,07 s | 1 | 119/120 | 0 |
| Netcup ARM 8000 · inicial · 5 | 2 | 2 | 6,142 s | 4,110 | 2,590 | 5,46 % | 11 / 54,7 s | 61,05 s | 0 | 120/120 | 0 |
| Netcup ARM 8000 · inicial · 6 | 1 | 2 | 3,541 s | 3,967 | 2,069 | 5,80 % | 11 / 54,9 s | 61,23 s | 0 | 117/120 | 447 |
| Netcup ARM 8000 · control · 1 | 4 | 1 | 4,090 s | 3,771 | 4,397 | 2,85 % | 11 / 54,3 s | 60,86 s | 0 | 119/120 | 0 |
| Netcup ARM 8000 · control · 2 | 4 | 2 | 1,631 s | 2,745 | 3,305 | 0,63 % | 12 / 58,6 s | 60,58 s | 0 | 119/120 | 0 |
| Hetzner CAX41 · inicial · 1 | 1 | 1 | 0,909 s | 2,049 | 2,649 | 0,00 % | 11 / 52,8 s | 60,34 s | 0 | 120/120 | 0 |
| Hetzner CAX41 · inicial · 2 | 2 | 1 | 0,835 s | 1,900 | 2,641 | 0,00 % | 11 / 53,8 s | 60,35 s | 0 | 120/120 | 0 |
| Hetzner CAX41 · inicial · 3 | 4 | 1 | 0,825 s | 1,723 | 3,677 | 0,00 % | 11 / 52,8 s | 60,32 s | 0 | 120/120 | 0 |
| Hetzner CAX41 · inicial · 4 | 4 | 2 | 0,765 s | 1,729 | 3,443 | 0,00 % | 11 / 54,2 s | 60,32 s | 0 | 120/120 | 0 |
| Hetzner CAX41 · inicial · 5 | 2 | 2 | 0,767 s | 2,017 | 2,465 | 0,00 % | 12 / 58,1 s | 60,39 s | 0 | 120/120 | 0 |
| Hetzner CAX41 · inicial · 6 | 1 | 2 | 0,815 s | 2,088 | 2,047 | 0,00 % | 11 / 54,0 s | 60,36 s | 0 | 119/120 | 0 |
| Hetzner CAX41 · control · 1 | 4 | 1 | 0,783 s | 2,102 | 4,383 | 0,00 % | 11 / 54,1 s | 60,35 s | 0 | 119/120 | 0 |
| Hetzner CAX41 · control · 2 | 4 | 2 | 0,841 s | 1,898 | 3,322 | 0,00 % | 11 / 52,8 s | 60,36 s | 0 | 120/120 | 0 |
Qué podemos concluir y qué sigue sin medirse
En estas dos instancias, con este perfil sintético de Chatwoot, Hetzner respondió más rápido y utilizó menos CPU en el control adicional. Netcup mejoró sus colas al ampliar trabajadores y mejoró la respuesta HTTP al ampliar conjuntamente el margen de PostgreSQL y Redis. La RAM máxima muestreada fue muy similar. Estos datos respaldaron nuestra decisión concreta de migración; no acreditan que la migración esté completada ni validan otras aplicaciones.
Se observó más tiempo steal en Netcup y variación entre rondas. El kernel define este contador como tiempo de CPU sustraído en un entorno virtualizado; la definición primaria de Linux permite interpretar el dato. No hemos aislado toda la causa física de la diferencia y el contador no prueba por sí solo una condición comercial o una política del proveedor.
- Son muestras breves de dos instancias, con dos repeticiones por ajuste. No certifican estabilidad durante días ni representan a todos los servidores de Hetzner o Netcup.
- No agotamos los 16 vCPU ni medimos el máximo de cuentas, agentes humanos o empresas. No hay una conversión válida de “38,6 % menos CPU media” a “38,6 % más clientes”.
- El generador compite por recursos dentro de cada host y la carga de fondo no era idéntica. No se midió la experiencia desde Santiago, la red pública, Meta, correo ni IA.
- El consumo de la pila sintética no es el de todas las aplicaciones del servidor. Los topes de recursos tampoco equivalen a recursos físicos reservados.
- Los ensayos usaron un Redis efímero. Esa configuración de laboratorio no es una recomendación de persistencia o recuperación para producción.
- No comparamos costes actuales en este artículo. Las tarifas históricas del Laboratorio conservan su fecha y no se reutilizan como precios vigentes.
Para repetir una decisión operativa, primero hay que fijar el perfil, los objetivos de respuesta y error, los límites y la recuperación del entorno aislado. Después se valida con los datos y medios reales del proyecto, con los canales y emisores productivos controlados. La capacidad nominal de RAM aporta margen; la elección final necesita saber cómo responde la aplicación.
Datos saneados y método para revisar los resultados
El paquete conserva las 9.600 solicitudes con su operación, duración, estado y tiempo relativo; las muestras de recursos y colas; y los resúmenes originales de eventos por ronda. Los hosts tienen alias públicos. Los originales con accesos e identificadores operativos se mantienen privados.
La descarga contiene las 9.600 solicitudes saneadas en JSON, los resúmenes por ronda, el protocolo, los scripts de cálculo y las figuras PNG/SVG. No contiene credenciales, datos de clientes ni planes editoriales internos.
La CPU de cada ronda se obtiene de la diferencia de contadores cgroup entre la primera y la última muestra de la ventana, dividida por el tiempo cubierto. Para el resumen se promedian las dos medias. La RAM se calcula como el máximo de la suma simultánea, no como la suma de máximos individuales de procesos. Los tiempos y la cobertura del muestreo están en la descarga.
La generación de gráficos y el análisis offline no ejecutan tráfico. Una repetición del ensayo necesita recrear un entorno sintético aislado y revisar su autorización, versiones y perfil. El protocolo no convierte estos resultados en un tamaño máximo de servidor o en un nivel de servicio contratado.
El aprendizaje amplía el método de CPU publicado y el método propuesto para WooCommerce. Los resultados de aquellas entradas permanecen intactos; la evidencia de Chatwoot pertenece a esta nueva serie.
Cómo recalcular los resultados sin generar tráfico
Descomprime la descarga y ejecuta python scripts/analizar.py. Usa solo la biblioteca estándar de Python y reconstruye el resumen desde todas las muestras HTTP y los contadores. Para regenerar figuras, instala las dependencias de scripts/requirements.txt en un entorno virtual y ejecuta python scripts/graficos.py.
Los scripts leen archivos locales y no conectan con los servidores del ensayo. El protocolo conserva el perfil, las imágenes por digest, el orden, los topes y los límites de reproducción. Los p95 de eventos se conservan por ronda; no se combinan sin sus duraciones individuales.
Siguiente paso recomendado
Convierte lo aprendido en un sitio que genere oportunidades
Cuéntanos qué debe lograr tu web, qué contenido ya tienes y cuál es el siguiente paso que esperas de tus visitantes.
Compartimos guías claras para que tu pyme tome mejores decisiones digitales.